L'IA che legge le labbra parte dalle parole più facili
Un gruppo del KAIST ha sviluppato DLLM-VSR, un sistema che trascrive il labiale decodificando prima le parole più chiare e usandole come contesto per quelle ambigue. Sul dataset LRS3 sbaglia il 19,4 % delle parole.
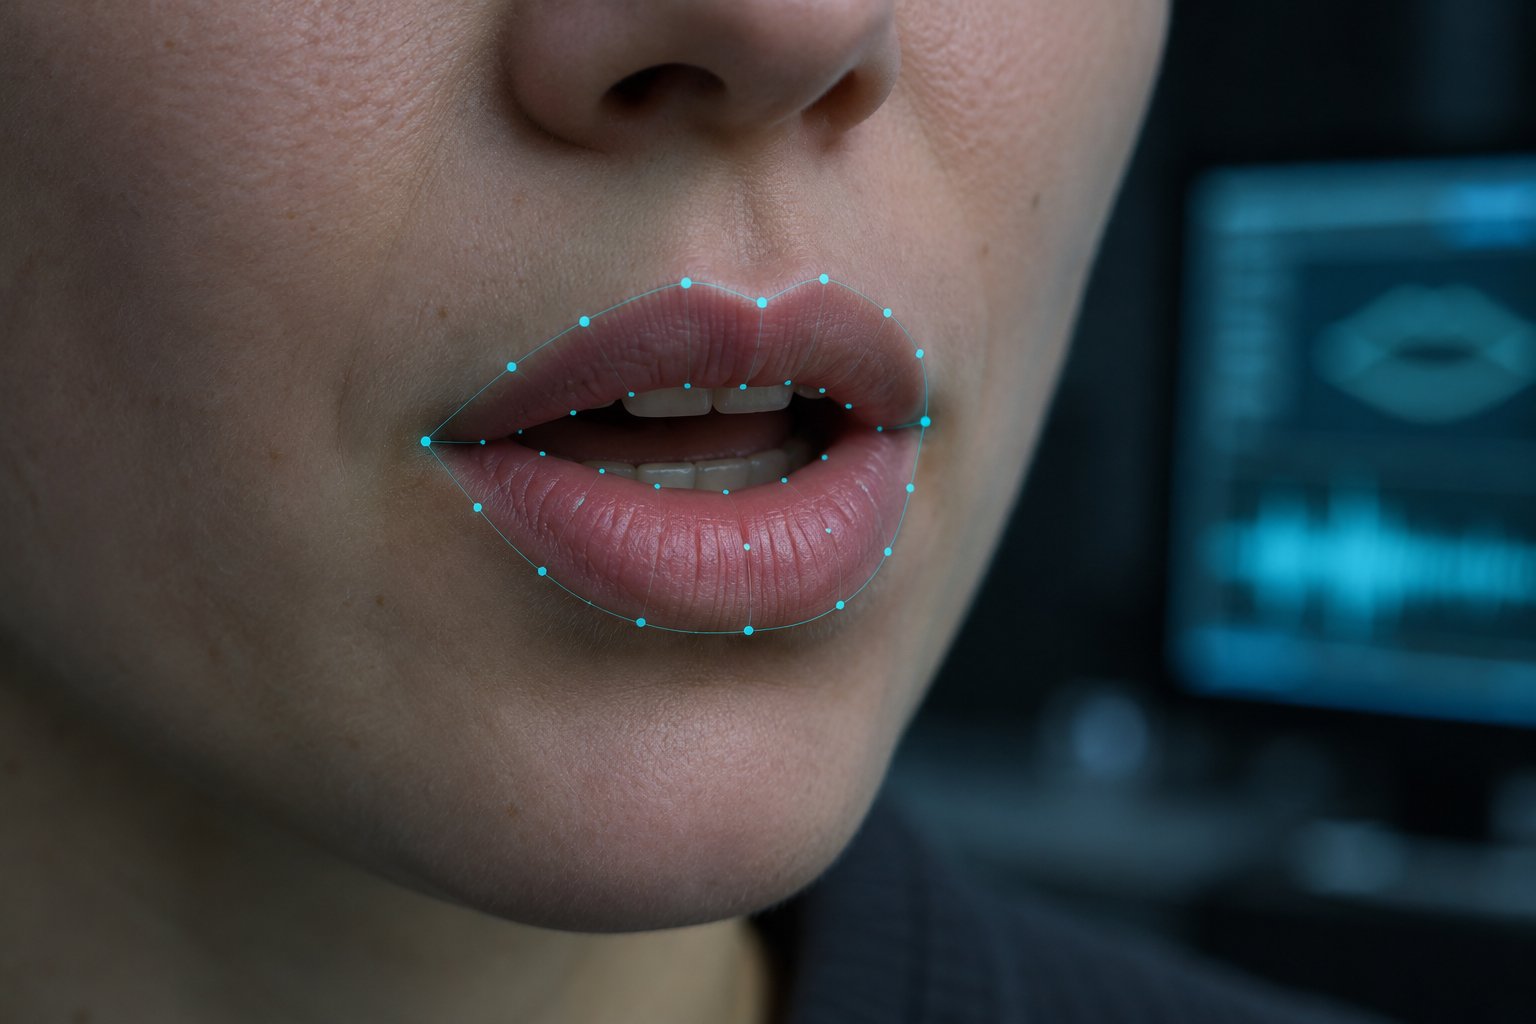
Chi ha seguito una conversazione in un locale affollato lo sa: guardare le labbra aiuta, ma solo fino a un certo punto. Molti suoni, infatti, si formano con movimenti della bocca quasi identici. Un gruppo del KAIST, il Korea Advanced Institute of Science and Technology, ha provato ad aggirare il problema con un'idea semplice: far partire l'intelligenza artificiale dalle parole di cui è più sicura, e lasciare quelle dubbie per ultime.
Il sistema si chiama DLLM-VSR e viene dal laboratorio del professor Yong Man Ro, della Scuola di ingegneria elettrica: secondo Ro dimostra che basta gestire in modo flessibile l'ordine in cui l'IA genera le parole per superare un limite di fondo della lettura labiale automatica. Lo studio, firmato da Jeong Hun Yeo, Chae Won Kim, Hyeongseop Rha e dallo stesso Ro, è disponibile su arXiv ed è stato accettato a EMNLP 2026, una delle principali conferenze internazionali sull'elaborazione del linguaggio naturale, dove secondo l'ateneo ha ricevuto un premio come Outstanding Paper.
Il problema delle lettere che si somigliano
In inglese, ricordano i ricercatori, i suoni /p/, /b/ e /m/ sono praticamente indistinguibili guardando solo la bocca. Per un sistema di riconoscimento visivo del parlato (in gergo VSR, visual speech recognition) è un ostacolo serio, soprattutto perché la maggior parte dei modelli costruisce la frase in ordine fisso, dalla prima parola all'ultima. Se sbaglia all'inizio, l'errore si trascina su tutto quello che segue.
La soluzione del KAIST è un diffusion large language model, un modello linguistico che non scrive il testo da sinistra a destra ma parte da una frase "mascherata" e la completa per passaggi successivi. Il sistema fissa prima le posizioni in cui la lettura delle labbra è più chiara, poi usa quelle parole come contesto, sia a monte sia a valle, per sciogliere i punti ambigui.
Resta un problema pratico: quanto è lunga la frase da trascrivere? Gli autori hanno separato l'addestramento in due fasi, una dedicata ad associare i movimenti delle labbra al testo e una alla lunghezza della frase. Al momento della trascrizione il modello usa la durata del video per stimare alcune lunghezze plausibili, produce una frase candidata per ciascuna e sceglie quella più convincente.
I risultati
Il modello è stato addestrato su LRS3, una raccolta di 433 ore di video tratti da conferenze TED e TEDx, abbinati alle trascrizioni corrette. Su questo banco di prova ha ottenuto un tasso di errore sulle parole (WER) del 19,4 %: in pratica, circa una parola su cinque risulta sbagliata, mancante o di troppo. Secondo gli autori è il risultato migliore tra i metodi che usano come dati etichettati soltanto LRS3, e si avvicina al 19,1 % di un sistema precedente addestrato però su oltre 3.400 ore di video trascritti.
Il confronto più diretto riguarda lo stesso tipo di architettura: sostituendo un modello linguistico tradizionale con quello a diffusione, a parità di componente visiva, l'errore scende dal 24,9 % al 21,9 %. Il gruppo riporta miglioramenti anche su LRS2, un dataset tratto da programmi della BBC, e su WildVSR, un banco di prova con video "dal mondo reale" diversi da quelli di addestramento.
Limiti e cautele
Gli stessi autori elencano diversi limiti. Valutare più lunghezze possibili per ogni frase allunga i tempi di calcolo, e il divario rispetto al caso ideale, in cui la lunghezza corretta è nota in anticipo, non è stato colmato del tutto. I test riguardano solo l'inglese, e non è stato verificato se le prestazioni cambino tra parlanti o gruppi demografici diversi: per questo i ricercatori sconsigliano di usare il sistema in contesti delicati senza un'attenta validazione e una supervisione umana.
C'è poi una questione di privacy, che il paper stesso solleva: una tecnologia del genere potrebbe ricavare il contenuto di un discorso da video muti, senza il consenso di chi parla.
Le applicazioni immaginate dal KAIST sono soprattutto due: capire cosa si dicono i lavoratori in ambienti industriali rumorosi e realizzare dispositivi che trasformino in testo il labiale per le persone sorde o con problemi di udito. Il prossimo obiettivo è ridurre dimensioni e costo computazionale del modello, così da farlo funzionare in tempo reale su dispositivi indossabili e robot, senza connessione a internet.
Immagine: Immagine generata con IA (OpenAI)
Fonte: arXiv
Redazione NovaScience
Autore su NovaScience. Leggi tutti i suoi articoli →